
ГРАФОВАЯ НЕЙРОДИНАМИКА КАК НАПРАВЛЕНИЕ РАЗВИТИЯ И ПРИМЕНЕНИЯ ОБЩЕГО ИСКУССТВЕННОГО ИНТЕЛЛЕКТА
А. Ф. Зохрэ, В. В. Ткаченко
Объединенный институт проблем информатики НАН Беларуси, Минск
Введение
С момента появления архитектуры Transformer [1] и последующего взрывного роста Больших языковых моделей (LLM), в индустрии закрепилось мнение о создании систем, близких к когнитивным процессам человека. Однако при строгом анализе современные ИИ-системы не являются «честными» нейросетями в биологическом смысле. Они представляют собой колоссальные статистические машины для авторегрессионного предсказания последовательностей [2].
Не “думает” а гадает (предсказывает вероятность токена)
Технология LLM (трансформеров) это не “честная” технология семантических операций, а по сути ее имитауия, – за счет гигансткого набора статистики, что дает возможность “предсказывать” (угадывать) какое следующее слово написать на основе уже написанного ранее текстового запроса и начальной части гадания…
Попытки преодолеть фундаментальные ограничения LLM привели к созданию технологий RAG (Retrieval-Augmented Generation) [3] и мультиагентных систем. Тем не менее, эти надстройки лишь имитируют когнитивную деятельность.
Трансформер вычисляет вероятности статических токенов в изолированном контекстном окне, не обладая внутренней динамикой, распределенным вниманием во времени и истинным пониманием причинно-следственных связей. Это условное приближение, основанное на плотных матричных вычислениях, бесконечно далекое от событийной (event-driven) природы реального мозга [4].
Имитация вместо нейронной сети
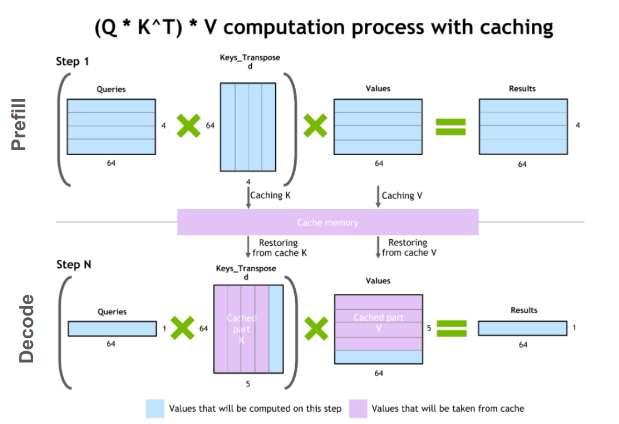
Математический алгоритм моделирования нейронных взаимодействий в LLM лищь отдаленно повторяет некоторые из многих важных свойств настоящих нейронных сетей.
Иллюзорность «нейросетевой» природы современных трансформеров, RAG и агентных систем. Фундаментальной проблемой современного глубокого обучения является алгоритм обратного распространения ошибки (Backpropagation). В биологических нейросетях обучение происходит локально, в реальном времени, за счет изменения синаптической пластичности между конкретными активированными нейронами (правило Хебба).
В LLM «обучение» — это ресурсоемкий комбинаторный подбор градиентов для миллиардов коэффициентов (весов) во множестве слоев [5]. Это не процесс познания, а глобальная математическая оптимизация. Для того чтобы модель «выучила» один новый факт, алгоритм должен микроскопически скорректировать огромные массивы матриц, прогнав через них терабайты данных. Этот процесс требует гигантских затрат энергии [6] и не имеет ничего общего с элегантной экономичностью мозга [7, 8].
Архитектура многослойного перцептрона и механизм обучения LLM органически не приспособлены к выборочному усвоению или изменению отдельных знаний. Знания в трансформере «размазаны» (distributed representation) по миллиардам статистических параметров. Если система получает новую информацию, противоречащую ранее усвоенной (конфликт знаний [9]), невозможно просто «перезаписать» один узел. Любое дообучение неизбежно затрагивает массивные слои весов, что приводит к деградации ранее усвоенных навыков. Модель не может локализовать опыт; она вынуждена каждый раз пересчитывать глобальный баланс всей сети, что делает непрерывное познание мира (online learning) в парадигме LLM технически невозможным без полного или частичного дорогостоящего переобучения (fine- tuning).
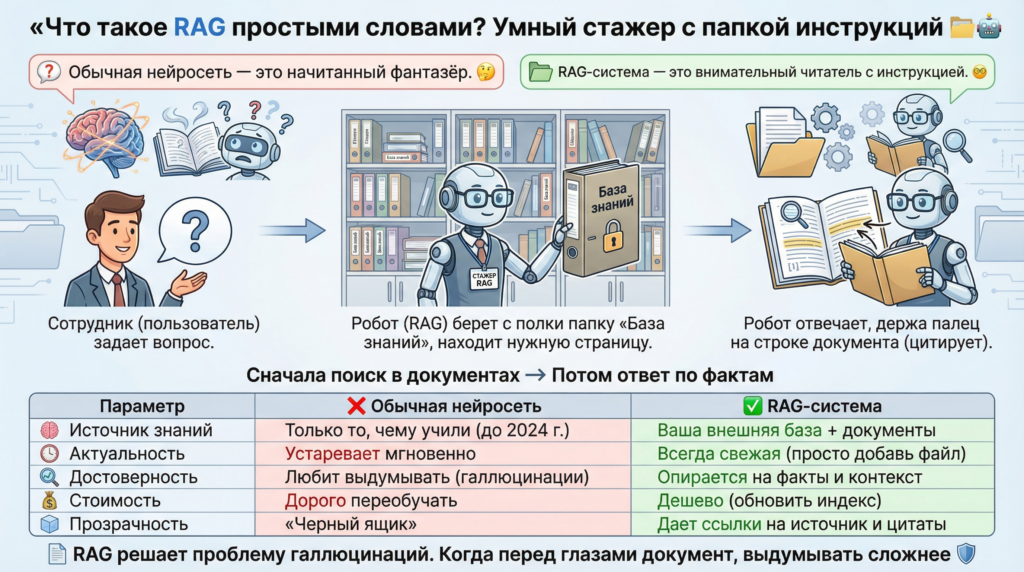
RAG – «костыль для хромой утки»
Чтобы обойти принципиальную невозможность локального обновления памяти, индустрия перешла к внешним компенсирующим, таким как технологии RAG [9], механизмам извлечения внешнего контекста для дообучения LLM. Однако исследования показывают, что модели часто игнорируют контекст, теряют информацию в середине (проблема "Lost in the Middle") [10, 11] и продолжают галлюцинировать [12, 13]. Мультиагентные системы (Multi-Agent LLM) пытаются разделить задачи, но сталкиваются с лавинообразным ростом ошибок передачи, проблемами маршрутизации и каскадными сбоями [14].
Применение retrieval-слоев, reranker-ов и ревизии данных — это усложнение инженерной инфраструктуры вокруг статичной модели [15]. Показательно, что даже корпорация Microsoft признала недостаточность однородного ембеддинга («наивного») RAG, предложив графовый — GraphRAG [16], что фактически подтверждает: без структурной графовой организации знаний сложные когнитивные задачи нерешаемы.
Концепция «честной» нейросети
В реальной нейросети:
- Нейроны не расположены слоями, а соединяются почти произвольно, в зависимости о функций и знаний сети.
- Нейроны моздают, изменяют, удаляют свои связи в зависимости от новых знаний и их подтвержденной достоверности.
- Сеть может динамически создавать, удалять или перепрофелировать нейроны.
- Сеть экономно тратит энергию только на ничтожную часть нейронов, нужных в данный момент времени, а не вычисляет все миллиарды связей для каждого символа.
Предлагаемая авторами концептуальная модель графовой нейродинамики обоснована необходимостью перехода от статистических авторегрессионных моделей (LLM) и компенсирующих технологий (RAG, мультиагентные системы) к гибридной когнитивной графово-символьной нейросетевой системе (ГНС). Анализируется несостоятельность алгоритма обратного распространения ошибки как биологически релевантной модели обучения.
Предлагается архитектура «сети предикторов», где узлы имитируют работу кортикальных колонок мозга, конкурируя за фокус внимания в «активной зоне».
Данный подход обеспечивает на доступных вычислительных ресурсах сверхдешевое интерактивное непрерывное обучение, устраняет проблему галлюцинаций и открывает путь к созданию пототипов Общего искусственного интеллекта (AGI), честно моделирующий бионические достижения миллионов лет эволюции живых систем.
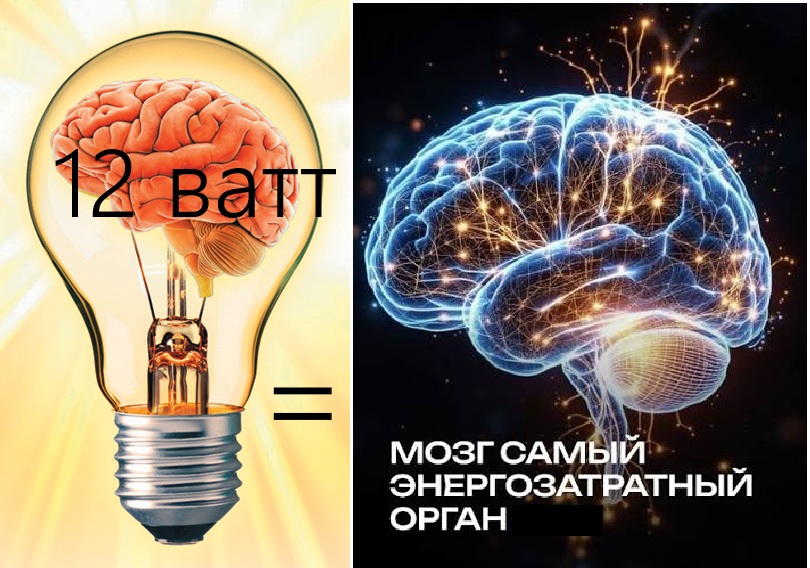
12 ватт живого мозга вместо сотен киловатт на один токен
Как работают настоящие нейросети? Почему мозг академика, весь его порясающий интеллект потребляет примерно 12-15 ватт, в моменты напряжонного мышления?
В отличие от LLM, биологические нейросети — даже у простейших организмов с тысячами нейронов — демонстрируют высокую гибкость, и невероятную (по техническим меркам) энергетическую экономичность.
Их работа строится наследующих принципах:
1. Разреженность (Sparsity): в каждый момент времени активируется лишь крошечная доля нейронов, связанных с текущей задачей.
2. Асинхронность: нет единого тактового генератора (как при перемножении матриц). Сигналы (спайки) передаются асинхронно, по мере накопления потенциала [17].
3. Непрерывность локального обучения: каждое взаимодействие с миром мгновенно меняет локальные синапсы, позволяя организму запоминать опыт спервого раза (rapid online learning) [18]. Это делает мозг энергоэффективным и адаптивным, в то время как LLM требуют наращивания ычислительныхмощностей даже на этапе вывода (Inference Scaling) [19, 20].
Попытки которые были до нас
Попытки переноса биологических принципов в инженерную плоскость предпринимались неоднократно во многих научных школах: нейробиологии, психофизиологии, микро и радиоэлектроники.
Существенное развитие в этих междисциплинарных исследованиях получило математическое моделирование, начиная с теории функциональных систем, основы которой заложены. Вот краткий список наших предшественников:
- П. К. Анохиным и получили развитие в рамках алгебраической биологии идругих разделов теории систем [21].
- Г. В. Римским. – алгебрологической подход к описанию процессов араллельногопроектирования и разработки сложных технических объектов, которыйразработан в начале 90-х годов [23] в ОИПИ НАН Беларуси (в то время Институт технической кибернетики НАН Беларуси). Им предложен способ описания и управления информационной моделью предметной области в виде семантического полигона
- Е. Н. Соколову сферическая (векторная) модель нейромоторной системы в парадигме векторной психофизиологии по[22] так и графовые модели, в частности.
- В. В. Голенков (доктор наук, профессор) БГУР РБ, – еще в конце 90-х предложил, и по сегоднишний день продолжает развивать наиболее близкую к GNN Socrates технологи. OSTES. Его идей в большой степени повлияли на уточнение нашей технологии.
Почему забыли, перешли к имитации с помощью LLM?
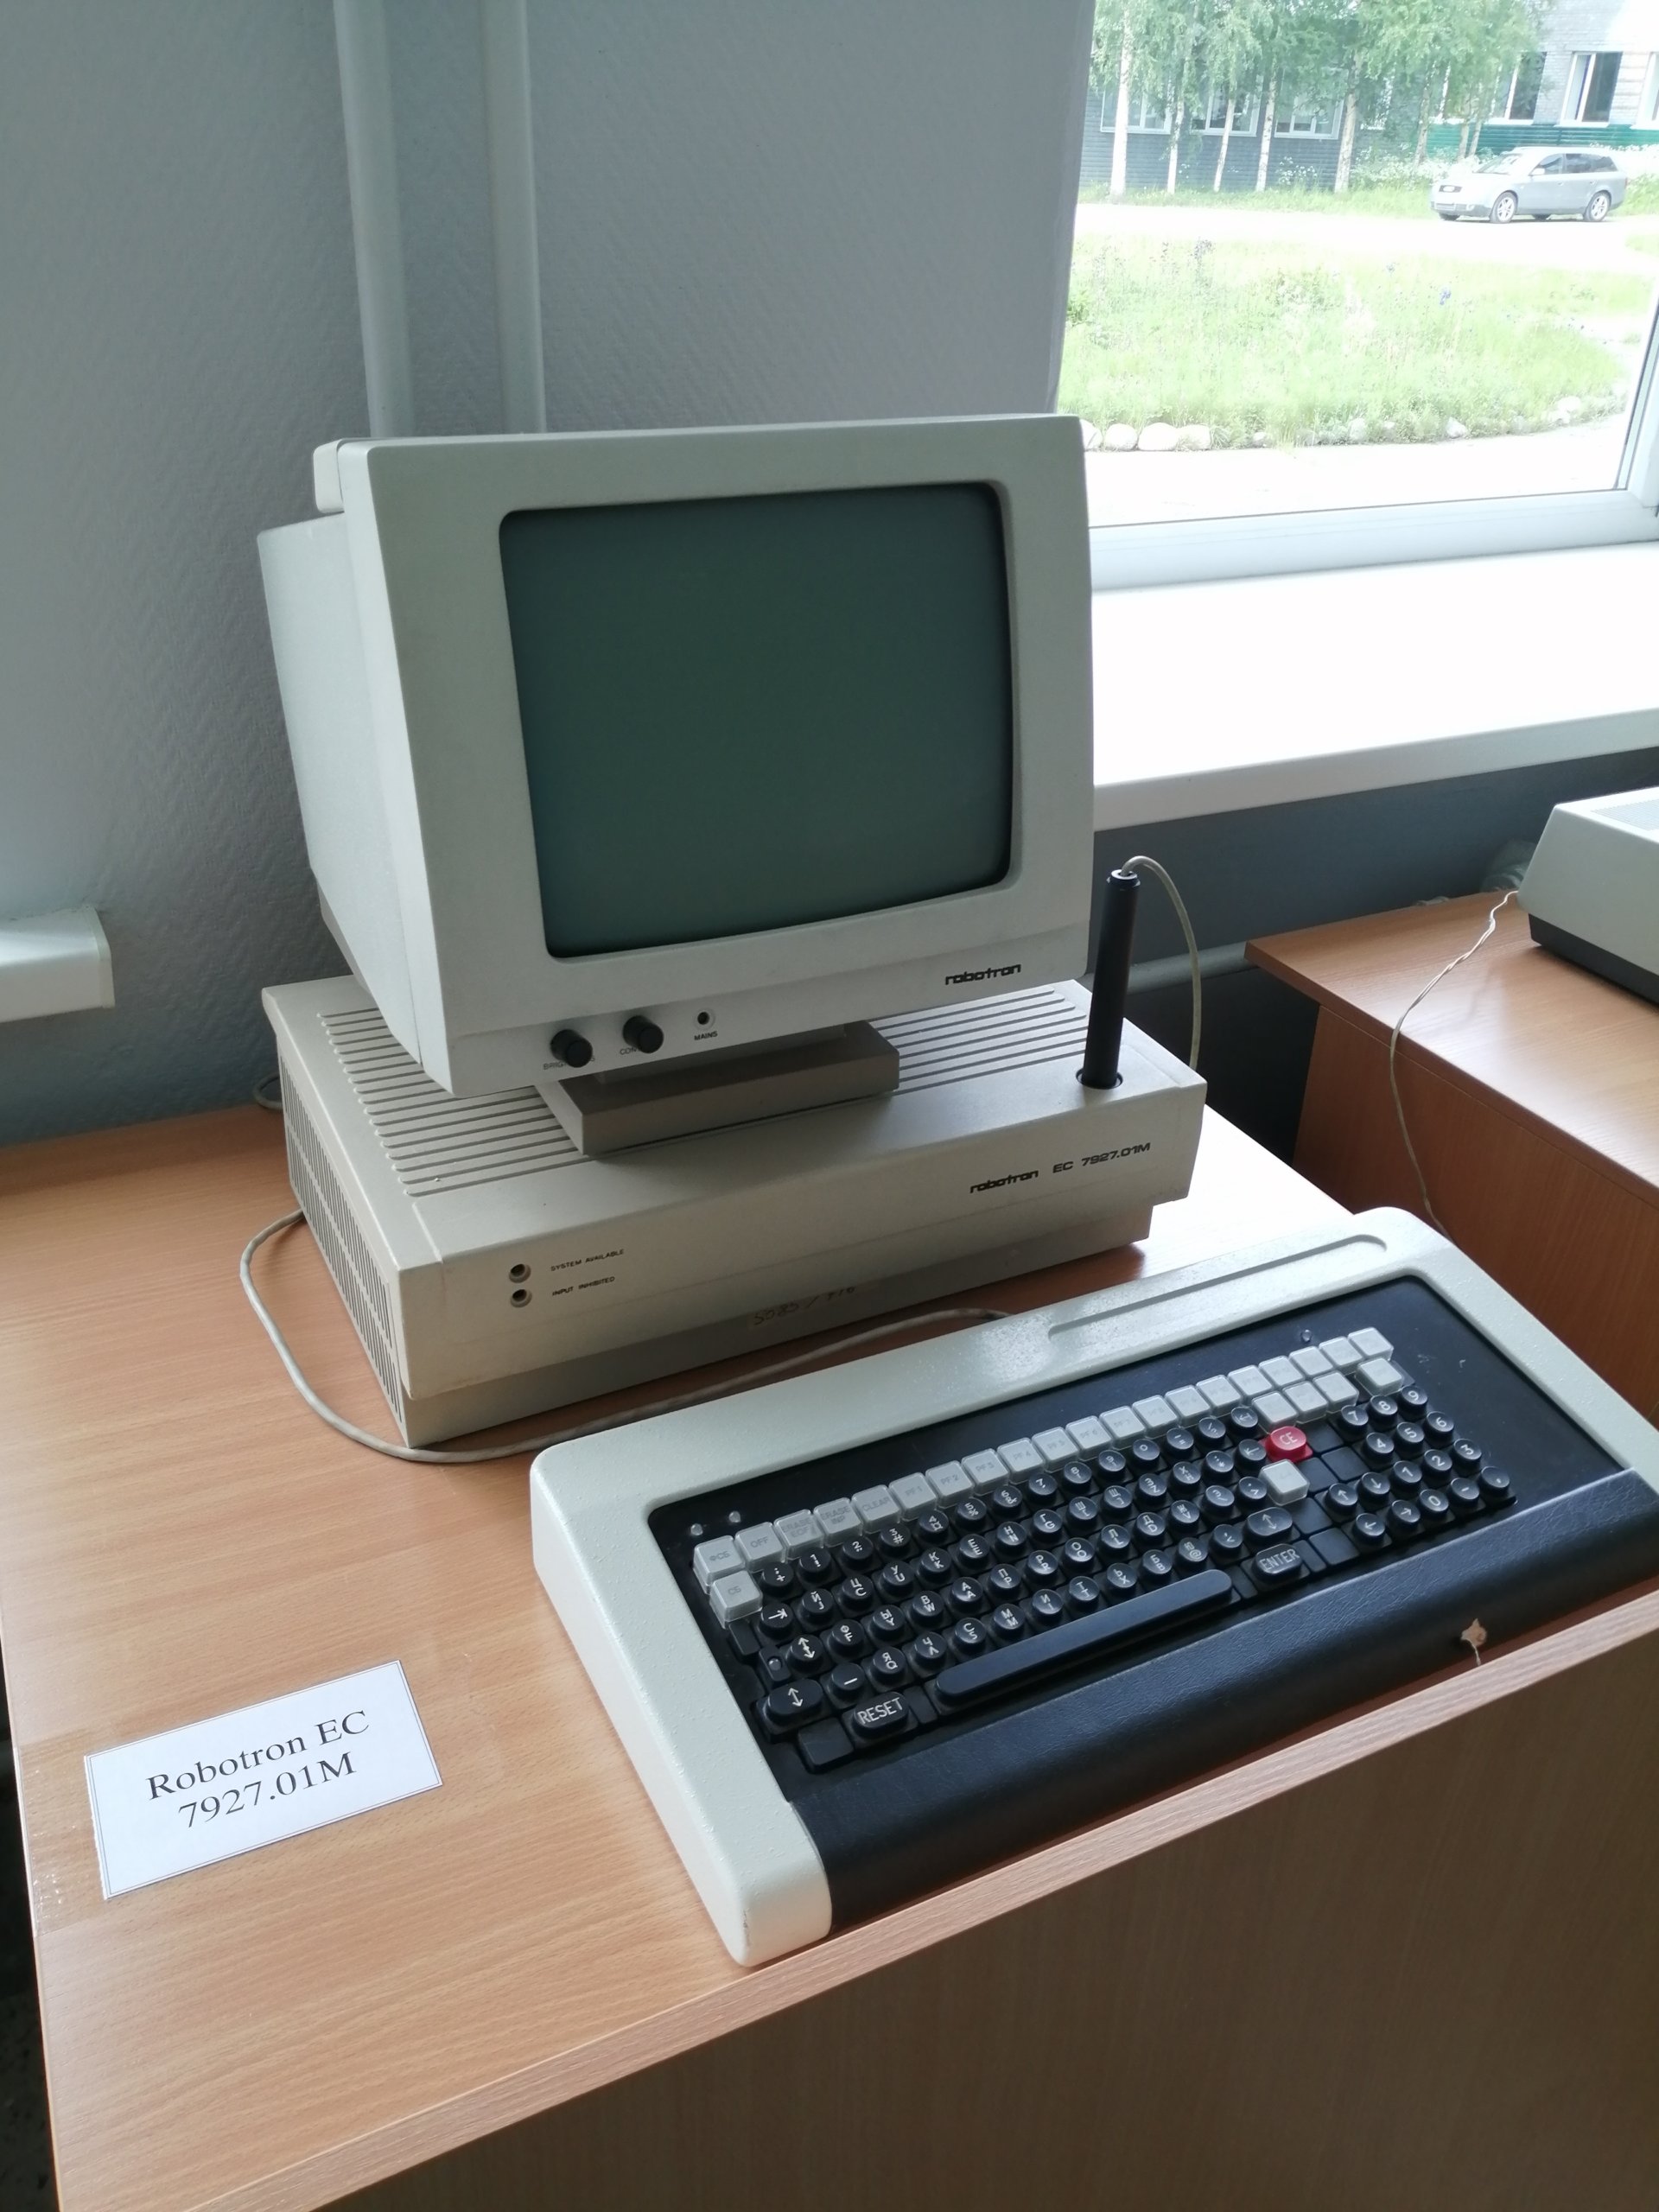
И уже во времена СССР были разработано программное обеспечение для управления динамическим процессом на многопроцессорной вычислительной системе. Это был путь, позволял семантически точным классическим графам знаний придать вычислительную нейродинамику, но он не был осуществлен по двум ричинам:
1. Отсутствие достаточной технологической базы, требуемой вычислительной мощности, методов автоматической классификации сущностей.
2. Развал СССР, и унизительная для всей отечественной науки, навязанная экономикой тенденция к копированию зарубежных уже готовых достижений.
Новый технологический уровень открывается с возможностями синергетического синтеза, предлагаемого авторами и их соратником — ныне ушедшим доктором наук Г.В. Лосиком, в котором объединяются нейродинамика, графовое представление знаний и символьные механизмы когнитивного управления.
Ахитектура ГНС
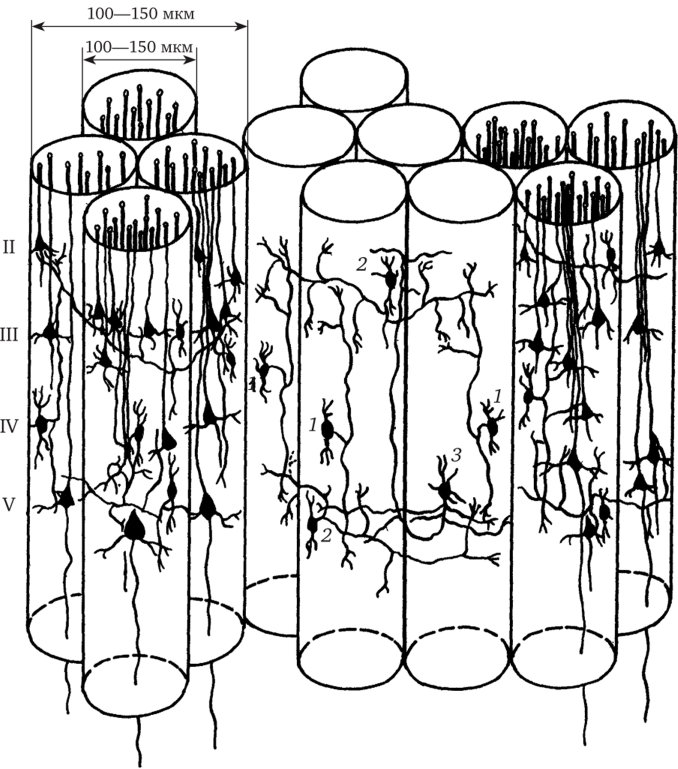
Идея архитектуры проверенна самой Природой, – это структура кортикулярных колонок мозга, каждое из которых не безликий нейрон, а понятие – сущность известная мозгу.
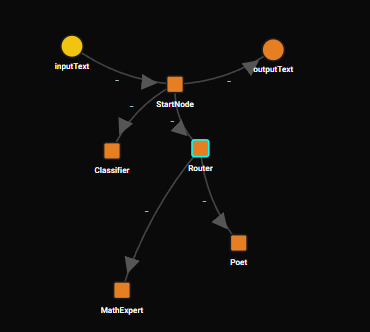
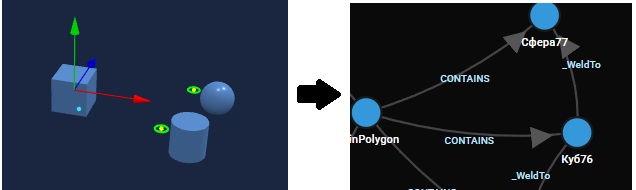
Классические безликие математические нейроны LLM или сумматоры Спайковой нейронной сети заменяются интеллектуальными микро-агентами (концептами), встроенными в единый динамический граф.
А предложенная белорусским ученым Александром Фаруховичем Зохрэ уникальная архитектура гибридного управления вниманием внутри графа, позволяет преодолеть «проклятие тяжолых графовых вычислений и тупик пассивных узлов» свойственные традиционным подходам в этом направлении.
В основу архитектуры ГНС (уже создан прототип CAD “Socrates”) положен принцип работы коры головного мозга, где базовым вычислительным элементом является не отдельный нейрон, а кортикальная колонка (нейронный ансамбль, содержащий до 5000 нейронов). В системе, реализованной в коплексе программ «SOCRATES», каждый концепт (узел графа) выступает программным аналогом такой колонки.
Это не просто переменная с весом, а сложный автономный модуль, отвечающий за одну известную системе сущность, свойство или действие. Концепт может инкапсулировать в себе любую логику: он может быть микро-LLM, логическим процессором, сенсорным интерпретатором или скриптом. Разделение знаний на такие независимые, но глубоко связанные сущности позволяет системе строить масштабные когнитивные модели без потери детализации.
Отличительная особенность ГНС заключается в том, что это не база знаний (сеть хранения знаний), а сеть предикторов. В биологии мозг не просто пассивно хранит образы, он ежесекундно предсказывает следующее состояние реальности.
В предложенной архитектуре каждый узел-концепт является активным предсказателем. Активируясь, он формирует гипотезу (прогноз) о том, какие связанные с ним события или сущности должны появиться в активной зоне следующими, исходя из обстоятельств реального мира. Если реальность (или входящие данные) совпадает с предсказанием — связь подкрепляется. Если возникает рассогласование (ошибка предикции) — система мгновенно и локально корректирует связи. Таким образом, каждый элемент самостоятельно изучает и отвечает за свою узкую сущность, а их синергетическое, конкурентное взаимодействие рождает то, что мы называем
Список использованных источников
1. Deeper insights into retrieval augmented generation: The role of sufficient context / Cyrus Rashtchian et al. – Mode of access: https://research.google/blog/deeper-insights-into-retrieval-augmented-generation-the-role-of-sufficient-context/?utm_source=chatgpt.com – Data of access: 20.08.2026.
2. Which Agent Causes Task Failures and When? On Automated Failure Attribution of LLM Multi-Agent Systems / Zhang et al. // Proceedings of the 42nd International Conference on Machine Learning, PMLR 267:76583-76599, 2025.
3. Beyond Individual Intelligence: Surveying Collaboration, Failure Attribution, and Self-Evolution in LLM-based Multi-Agent System / Shihao Qi et al. – Mode of access: https://arxiv.org/abs/2605.14892 – Data of access: 20.08.2026.
4. Towards spike-based machine intelligence with neuromorphic computing / Roy K. et al. // Nature, 575. – 2019. – P. 607-617.
5. Training Compute-Optimal Large Language Models / Hoffmann J. et al. Mode of access: https://arxiv.org/abs/2203.15556?utm_source=chatgpt.com – Data of access: 20.08.2026.
6. Energy and Policy Considerations for Deep Learning in NLP / Strubell E. et al. // Proceedings of the 57th Annual Meeting of the Association for Computational Linguisticsttps, Florence, Italy. – 2019. – P. 3645–3650.
7. Physics for neuromorphic computing / Danijela Marković et al. // Nature Reviews Physics, vol. 2, 2020. – P 499–510.
8. Spike-based dynamic computing with asynchronous sensing-computing neuromorphic chip / Yan et al. // Nature Communications, 15, 2024. Article number: 4464.
9. Huang Y. Survey on Retrieval-Augmented Text Generation for Large Language Models / Y. Huang, Huang J. – Mode of access: https://arxiv.org/abs/2404.10981?utm_source=chatgpt.com – Data of access: 20.08.2026.
10. From Local to Global: A Graph RAG Approach to Query-Focused Summarization / Darren Edge et al. – Mode of access: https://arxiv.org/abs/2404.16130 – Data of access: 20.08.2026.
11. Why Do Multi-Agent LLM Systems Fail? / Cemri et al. – Mode of access: https://arxiv.org/abs/2503.13657?utm_source=chatgpt.com – Data of access: 20.08.2026.
12. Astute RAG: Overcoming Imperfect Retrieval Augmentation and Knowledge Conflicts for Large Language Models / Fei Wang et al. //The Proceedings of the 63rd Annual Meeting of the Association for Computational Linguistics (ACL 2025). – Mode of access: https://arxiv.org/ abs/2410.07176. – Data of access: 20.08.2026.
13. Deeper insights into retrieval augmented generation: The role of sufficient context / Hailey Joren et al. – Mode of access: https://arxiv.org/abs/2411.06037 – Data of access: 20.08.2026.
14. Imam N., Rapid online learning and robust recall in a neuromorphic olfactory circuit / N. Imam, T. Cleland // Nature Machine Intelligence, N 2, 2020 – P.181-191.
15. Language Models are Few-Shot Learners / Brown T. et al. – Mode of access: https://arxiv.org/abs/2005.14165?utm_source=chatgpt.com – Data of access: 20.08.2026.
16. Attention Is All You Need / Vaswani A. et al. – Mode of access: https://arxiv.org/abs/1706.03762?utm_source=chatgpt.com – Data of access: 20.08.2026.
17. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks – ACL / Lewis et al. – Mode of access: https://arxiv.org/pdf/2005.11401. – Data of access: 20.08.2026.
18. Inference Scaling Laws: An Empirical Analysis of Compute-Optimal Inference for Problem-Solving with Language Models / Wu et al. – Mode of access: https://arxiv.org/abs/2408.00724?utm_source=chatgpt.com – Data of access: 20.08.2026.
19. Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters / Snell et al. 2024. – Mode of access: https://arxiv.org/abs/2408.03314?utm_source=chatgpt.com. – Data of access: 20.08.2026.
20. DataComp-LM: In search of the next generation of training sets for language models / Li et al. – Mode of access: https://arxiv.org/abs/2406.11794?utm_source=chatgpt.com. – Data of access: 20.08.2026.
21. Теория систем, алгебраическая биология, искусственный интеллект: математические основы и приложения / Всемирный конгресс — Биомашсистемы, том 9, № 3, июль-сентябрь 2025.
22. Векторная психофизиология: от поведения к нейрону / под ред. Е. Н. Соколова, А. М. Черноризова, Ю. П. Зинченко. – М. : изд-во Московского университета, 2019. – 768 с.
23. Римский Г. И. Теория систем автоматизированного проектирования: Интеллектуальные САПР на базе вычислительных комплексов и сетей. – Минск: Наука и техника, 1994. – 631 с.
24. A highly energy-efficient multi-core neuromorphic architecture for training deep spiking neural networks / Mingjing Li et al. – Nature Communications, 17, Article number: 4403 – 2026.